


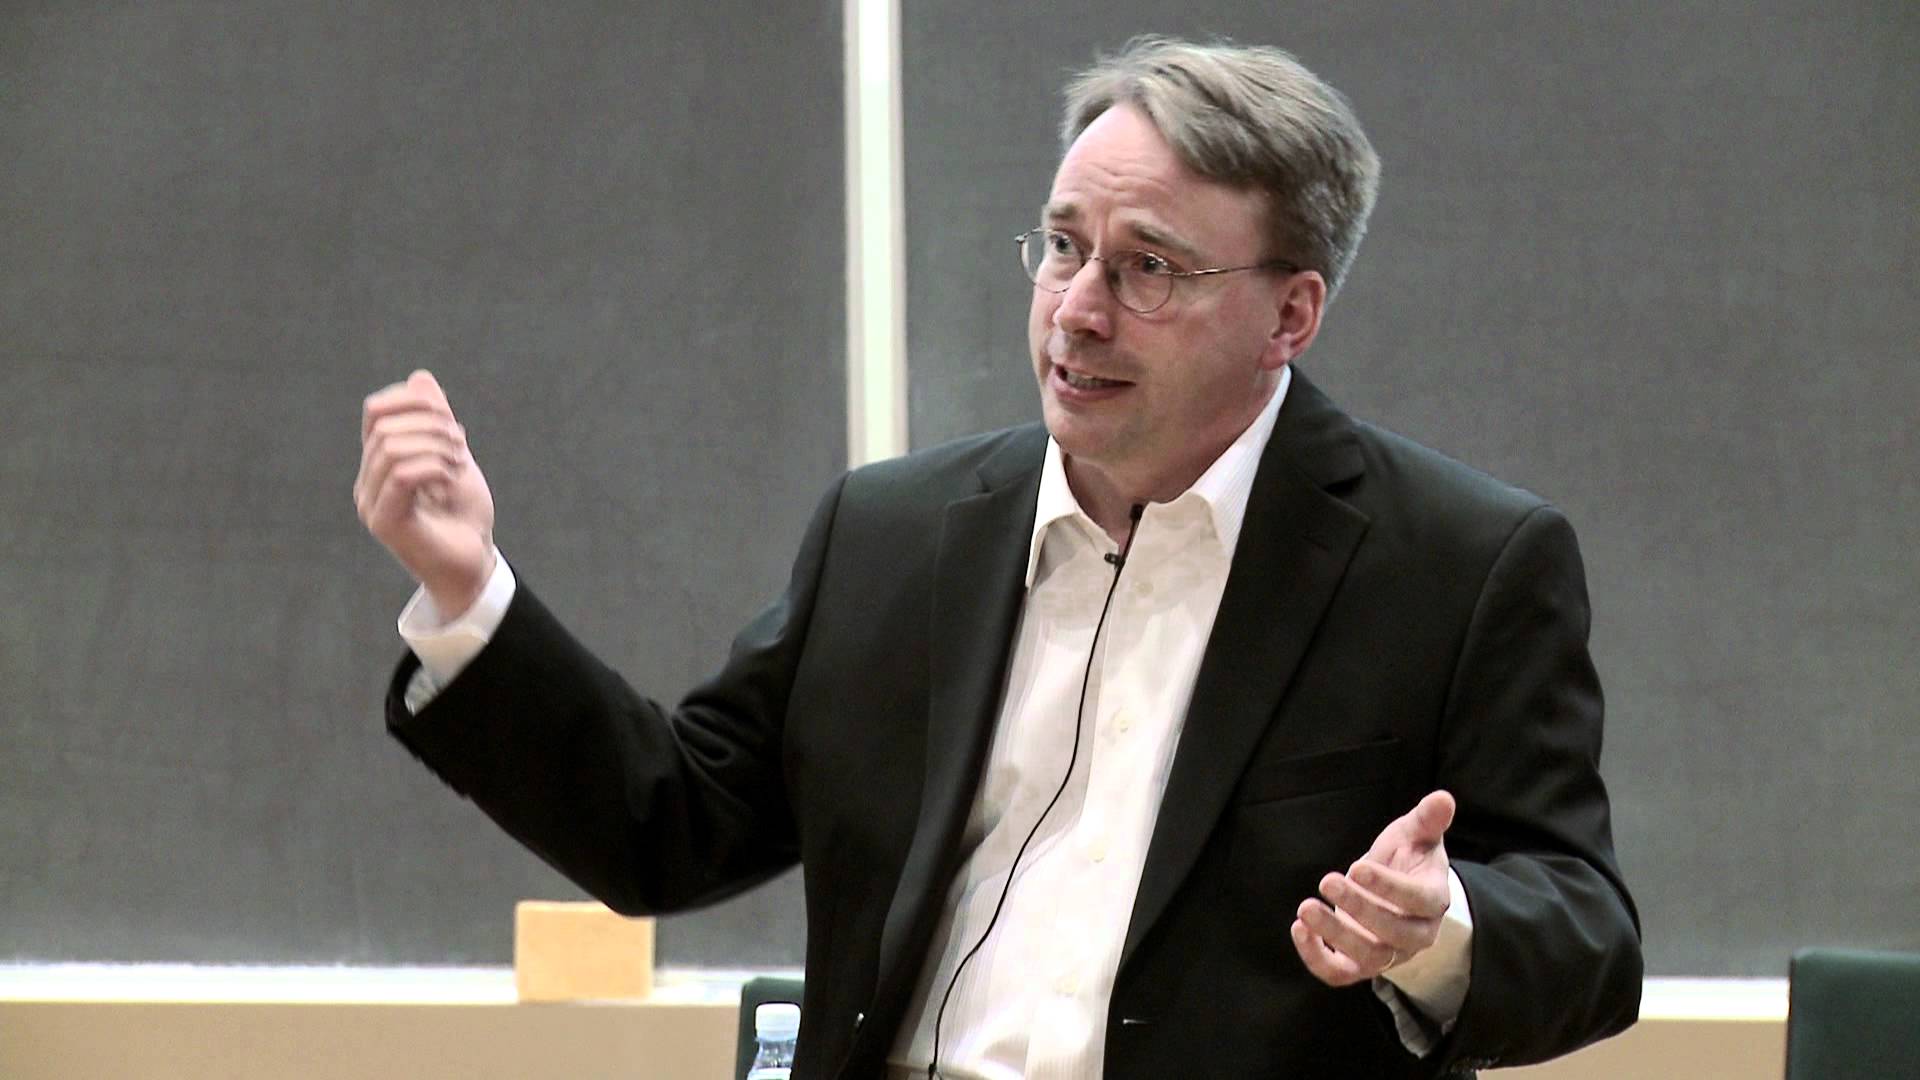
Linus Torvalds ha usato Claude Code per sviluppare una serie sperimentale di modifiche al kernel Linux. Il lavoro riguarda un punto poco visibile ma fondamentale del sistema operativo: la gestione delle letture dei file già presenti nella memoria cache. In un benchmark particolarmente favorevole, Torvalds ha registrato un’accelerazione fino a 23 volte. Il dato, però, non significa che Linux diventerà 23 volte più veloce: il codice è ancora sotto revisione e chi lo ha esaminato ha già individuato una condizione di gara da risolvere.
Che cosa ha fatto Torvalds con Claude Code
Il 13 ottobre 2026 il creatore di Linux ha presentato alla comunità degli sviluppatori una serie di patch sulla scalabilità della gestione delle pagine di memoria. Non si tratta di chiedere a un chatbot di scrivere un intero sistema operativo: l’obiettivo è eliminare un collo di bottiglia specifico incontrato quando molti processi leggono contemporaneamente piccole porzioni dello stesso file.
Il lavoro nasce da discussioni tecniche iniziate anni prima. Torvalds aveva già sperimentato una soluzione imperfetta; questa volta ha impiegato Claude Code come assistente per la scrittura del codice e dei programmi di test. Nella documentazione del suo ramo sperimentale del kernel attribuisce all’assistente anche una prima revisione delle criticità e una bozza della descrizione, precisando che le misurazioni sono state eseguite personalmente sul suo computer.
Perché un semplice contatore può rallentare Linux
Quando un programma legge un file che si trova già nella page cache, Linux può ottenere i dati dalla RAM senza recuperarli nuovamente dal disco. Per impedire che quella memoria venga liberata mentre è in uso, il percorso tradizionale aggiorna dei contatori di riferimento. Se decine di thread eseguono piccole letture sulla stessa pagina, tutti finiscono per contendersi l’aggiornamento degli stessi dati condivisi.
La proposta sperimenta un meccanismo basato su RCU (Read-Copy Update), che ritarda il rilascio di alcune pagine e permette di leggerle senza acquisire continuamente un nuovo riferimento nel percorso più rapido. È un cambiamento importante proprio perché tocca il rapporto tra prestazioni e sicurezza dell’accesso alla memoria: se il ciclo di vita della pagina non viene gestito correttamente, un’ottimizzazione può introdurre bug difficili da riprodurre.
Il test 23 volte più veloce non rappresenta un PC normale
La cifra più appariscente arriva da un test sintetico con numerosi thread che rileggono ripetutamente una piccola area di memoria su una macchina Ryzen Threadripper. In questa situazione il contatore condiviso è una parte enorme del problema e rimuoverne il costo produce un guadagno eccezionale. Il benchmark racconta quindi quanto pesa quel collo di bottiglia in uno scenario costruito per metterlo in evidenza, non quanto accelerino Windows, le applicazioni quotidiane o ogni distribuzione Linux.
La distinzione cambia completamente il significato della notizia. Una misura su una configurazione riproducibile è utile per gli sviluppatori, ma non equivale a promettere avvii più rapidi, videogiochi con più FPS o file copiati 23 volte prima. Non risultano prove generali che autorizzino queste conclusioni.
Perché la patch non è ancora pronta
La revisione pubblica ha già segnalato una race condition, cioè una situazione in cui il risultato dipende dall’ordine con cui avvengono operazioni concorrenti. Il problema richiede altre verifiche e correzioni prima di poter considerare il codice adatto all’integrazione nel kernel principale. Non è stata annunciata una versione stabile di Linux che includa sicuramente questo cambiamento.
Per questo il fatto più interessante non è soltanto la velocità misurata, ma il metodo: un assistente AI ha contribuito a produrre una proposta tecnica concreta, poi sottoposta agli stessi controlli pubblici e rigorosi di qualsiasi patch. L’AI può aiutare a esplorare una soluzione, mentre la responsabilità della correttezza resta degli sviluppatori e dei revisori.
Un cambio di prospettiva sull’intelligenza artificiale
Il contrasto è interessante per chi segue l’open source. Torvalds aveva già criticato l’eccesso di promesse commerciali sull’intelligenza artificiale; usare oggi un assistente per un problema concreto non significa considerare ogni risultato infallibile. Significa valutare lo strumento sul lavoro che produce e sui difetti che la revisione fa emergere.
Il contesto storico conta: il kernel Linux è cresciuto attraverso contributi e revisioni pubbliche. Questa sperimentazione non cambia quel principio: aggiunge un nuovo strumento al processo, non un lasciapassare per inserire automaticamente codice generato dall’AI.
Per chi usa Linux oggi non è necessario aggiornare nulla in seguito a questo esperimento. Il prossimo passaggio da seguire sarà la pubblicazione di una versione corretta delle patch, con nuove verifiche sulla sicurezza della memoria e benchmark su carichi meno artificiali.

Entra nella conversazione
Condividi il tuo punto di vista: non serve creare un account. I contributi restano soggetti alla moderazione editoriale.